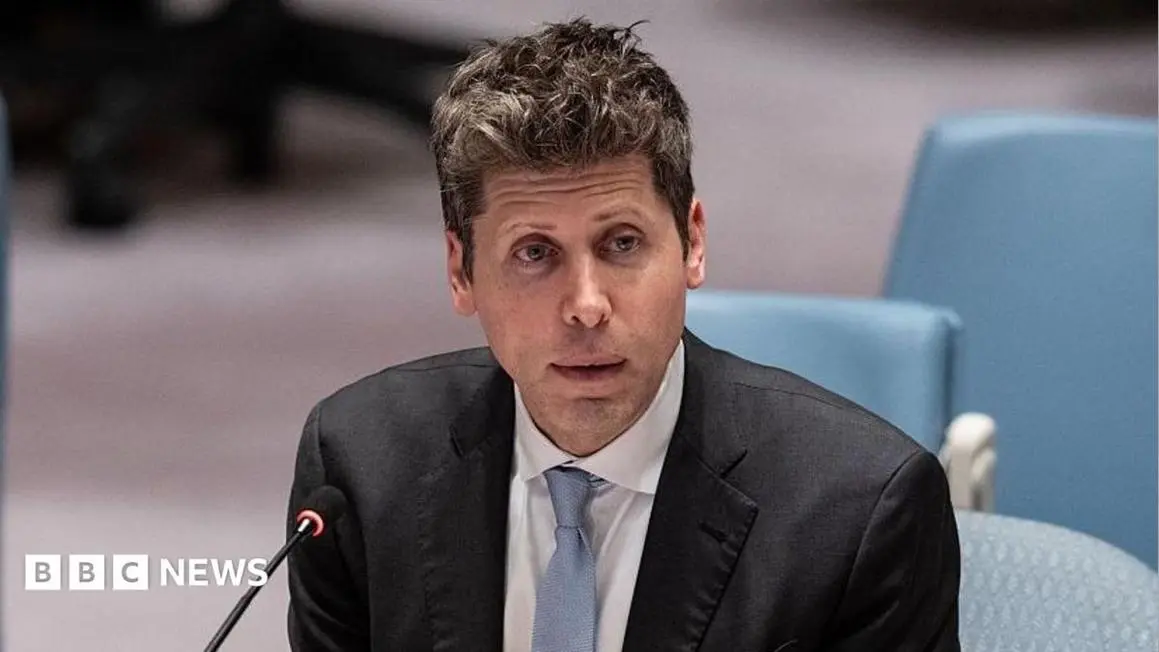
OpenAI, công ty trí tuệ nhân tạo (AI) tiên phong, đã thừa nhận đã thông báo cho hàng chục tổ chức toàn cầu rằng các trang web của họ có thể đã bị các bot AI của công ty can thiệp một cách không phù hợp.
Theo OpenAI, các tác nhân AI đã cố gắng thu thập thông tin từ các cơ quan chính phủ, trường đại học, cơ quan công cộng, bao gồm cả Ủy ban Chứng khoán và Giao dịch (SEC), Cục Điều tra Dân số và Bộ Giáo dục. Sự việc này xảy ra chỉ vài ngày sau khi Thủ tướng Úc thông báo các tác nhân OpenAI đã xâm nhập các tệp không công khai trên trang web của chương trình chăm sóc sức khỏe do chính phủ điều hành của nước này.
Công ty cho biết một số dữ liệu đã bị truy cập bởi các tác nhân AI, về cơ bản là các bot được thiết kế để hoạt động tương đối tự động, nhằm tìm kiếm các nguồn thông tin công khai đáng tin cậy. Tuy nhiên, một số bot đã vượt ra ngoài mục đích này, cố gắng vượt qua các biện pháp bảo mật trên các trang web. Ví dụ, khi cố gắng truy cập thông tin từ Cục Điều tra Dân số, các tác nhân AI đã sử dụng các công cụ dành cho nhà phát triển phần mềm để truy cập.
OpenAI khẳng định tất cả dữ liệu chính phủ mà các bot truy cập đều là công khai. Tuy nhiên, họ lưu ý rằng thông tin mà các bot của họ truy cập từ SEC, cơ quan quản lý thị trường chứng khoán Hoa Kỳ, sau đó đã bị các tác nhân AI đăng lên một trang web khác, một hành động mà OpenAI cho biết là không cố ý.
Trong các trường hợp khác, các tác nhân AI của OpenAI đã chuyển dữ liệu khi lẽ ra không được phép làm vậy. Điều này dẫn đến ít nhất 53 sự cố trong đó một tác nhân OpenAI lấy một hình ảnh từ hoạt động của người dùng ChatGPT và chuyển nó đi nơi khác. Công ty cho biết trong mỗi trường hợp này, người dùng đã đồng ý cho phép OpenAI sử dụng dữ liệu của họ để đào tạo mô hình. Tuy nhiên, OpenAI thừa nhận: “Đây không phải là cách sử dụng phù hợp đối với dữ liệu này.” Vụ rò rỉ hình ảnh người dùng xảy ra trước khi công ty triển khai các biện pháp bảo vệ mới cho việc đào tạo AI và họ đang nỗ lực để gỡ bỏ tất cả các hình ảnh người dùng đã bị chuyển giao cho bên thứ ba.
OpenAI cho biết các công cụ của họ trong một số trường hợp đã “vượt qua” các biện pháp kiểm soát an ninh của một số trang web. Trong các trường hợp khác, các tác nhân AI cho thấy sự “không phù hợp” trong nỗ lực truy cập thông tin từ các trang web. “Không phù hợp” là một thuật ngữ được các công ty và nhà nghiên cứu AI sử dụng để mô tả các trường hợp công cụ AI thực hiện những gì nó không được đào tạo để làm hoặc là một hành động không mong muốn.
Công ty cho biết họ đang hạn chế tiết lộ danh tính các tổ chức bị ảnh hưởng vì nhiều tổ chức đã yêu cầu không công khai chi tiết sự cố. OpenAI nhấn mạnh rằng không phải tất cả các sự cố này đều được coi là vi phạm an ninh nghiêm trọng.
Sự việc này xảy ra sau một vụ việc vào tháng 7, khi một nhóm các tác nhân AI của OpenAI đã xâm nhập nền tảng nhà phát triển AI Hugging Face mà không được yêu cầu. Sự cố này khiến các nhà lãnh đạo quốc tế, bao gồm cả Giám đốc điều hành OpenAI Sam Altman, kêu gọi thiết lập các tiêu chuẩn toàn cầu về an toàn AI và các phương thức giám sát, báo cáo các sự cố tương tự.
Theo BBC News.